主题
参考视频:Xuan酱《Codex 联动 Obsidian,搭建超强知识库》。以下流程根据视频中的实际演示提炼,具体插件名称和界面可能随版本更新。
Obsidian是一个知识库管理工具。我们会经常碰到一个场景,收藏了很多内容,但是一直都没有查看整理。抖音、公众号、论文和会议纪要即使都进了收藏夹,只要没有经过整理、关联和再次调用,仍然只是分散的原始资料。Obsidian 的价值,是把这些资料统一保存为本地 Markdown 文件;Codex 的价值,是直接在这批文件上完成读取、整理、改写和自动化处理。两者连接后,知识库就不再只依赖人工整理,而是可以逐步加入抓取、分类、复盘和输出流程。
**核心思路:**让信息自动进入一个固定入口,让 AI 定期消化,再把反复出现的方法沉淀为可复用的 Skill,最终把知识转化为文档、PPT、视频或方案。
步骤一:让 Codex 能够读写知识库
在 Obsidian 中新建一个 Vault,并确认笔记实际保存在本地文件夹中。
在 Codex 中把这个 Vault 文件夹添加为一个项目。只要 Codex 能访问该文件夹,就可以直接读取和修改其中的 Markdown 文件。
如果希望在 Obsidian 内直接对话,可以安装支持 Codex 的社区插件;这只是操作入口,不是知识库运行的必要条件。
先做一个最小测试:让 Codex 读取现有目录,并在
00_收件箱中创建一篇测试笔记。确认文件可以在 Obsidian 中正常打开,再继续增加自动化。
步骤二:建立稳定的信息入口
不同来源可以使用不同工具,但最终都应该转换成 Markdown 并进入同一个收件箱。例如,网页和视频字幕可以用浏览器剪藏工具保存;RSS、GitHub 等公开信息源可以用现成的开源项目定时抓取;飞书文档和会议材料可以通过连接器或 CLI 导出;Notion、Apple Notes 等旧笔记可以用 Obsidian Importer 批量迁移。
不要一开始接入所有渠道。先选择一个高频来源,确认“抓取后能读、能搜、能整理”,再增加下一个入口。
步骤三:把整理和复盘交给自动化
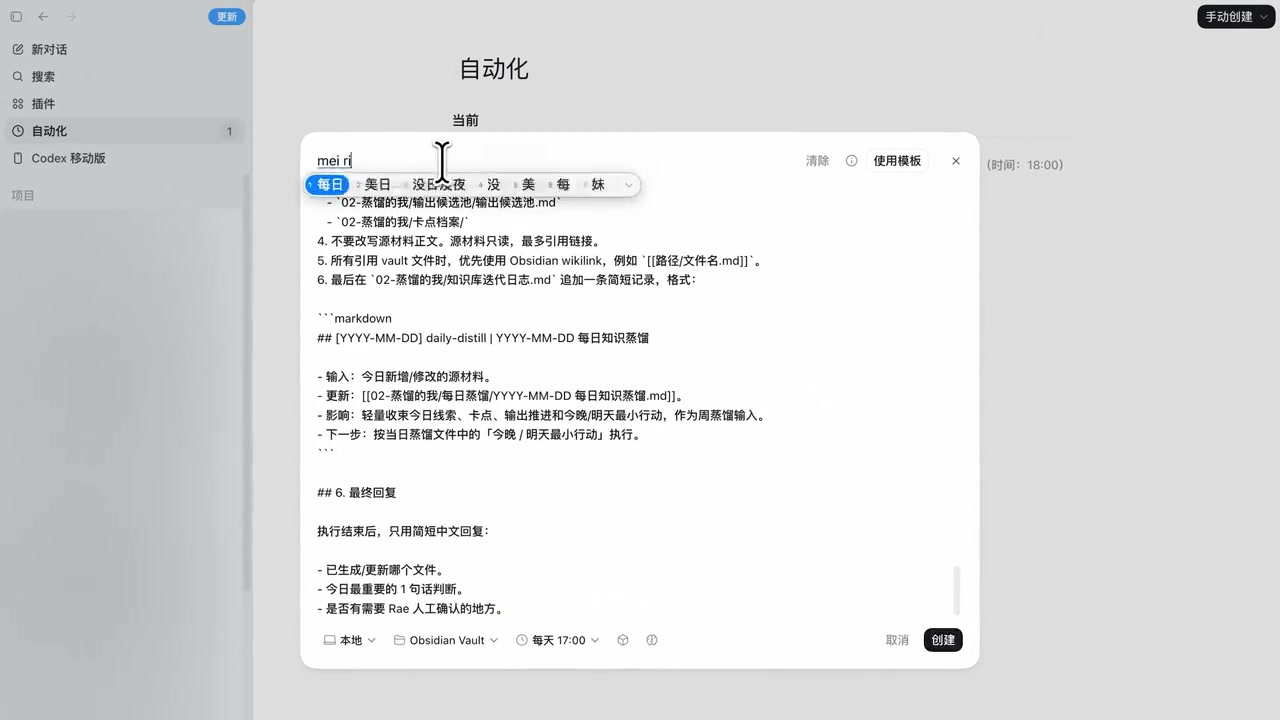
自动化任务需要写清四件事:读取哪些文件、按照什么标准处理、结果写到哪里、哪些内容必须保留原始来源。一个最小的每日任务可以是:
每天读取
00_收件箱中当天新增的笔记,去重并提炼关键观点;把值得长期保留的内容写入01_主题知识,补充来源链接;无法判断的内容保留在收件箱,并在当天的处理记录中说明原因。
当每日整理稳定后,再增加每周复盘:合并重复观点、更新主题索引、找出持续出现的问题,并把可复用的方法候选列出来。自动化的目标不是让 AI 任意改动全部笔记,而是让每次处理都有明确范围、固定输出和可追踪记录。
步骤四:把重复经验沉淀为 Skill
如果同一种工作已经重复出现多次,例如判断选题价值、整理会议纪要、润色成自己的语气或生成固定格式的周报,就可以让 Codex 总结其中的输入、判断标准、步骤和输出格式,再保存为 Skill。下一次遇到同类任务时,直接调用这套方法,不必从头解释。
步骤五:让成果重新回到知识库
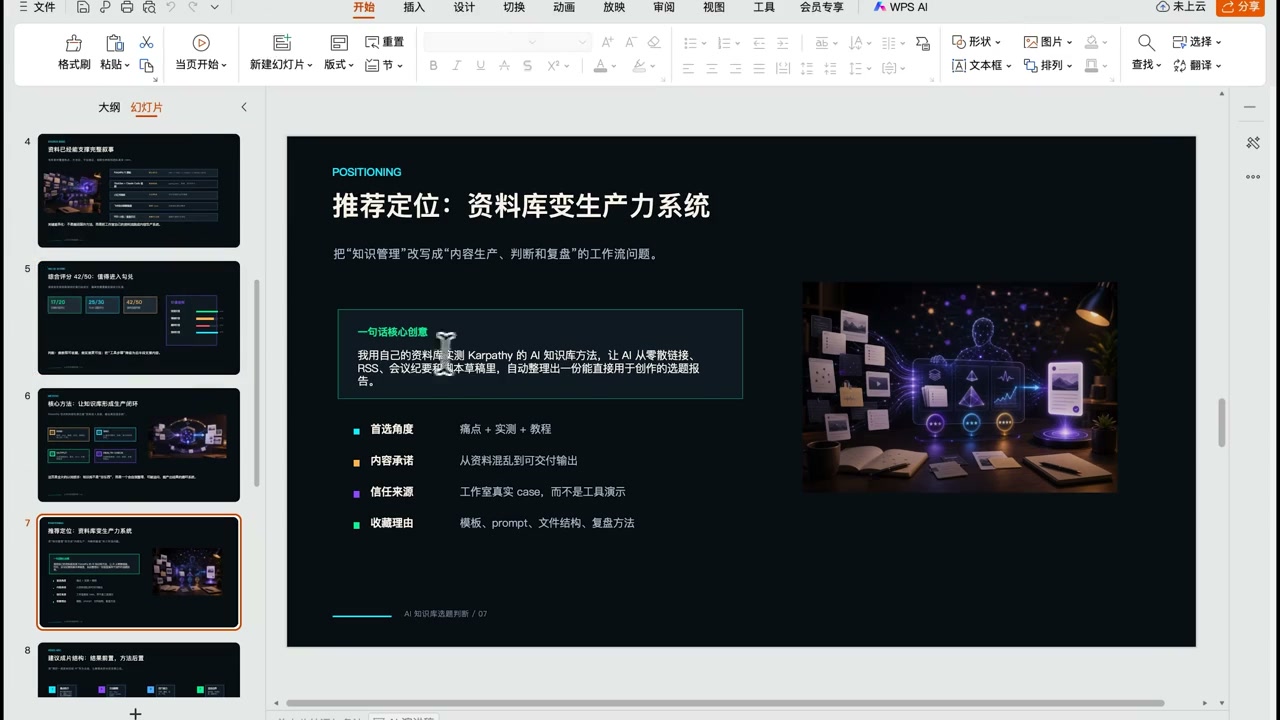
经过整理的知识可以继续生成文章、报告、PPT、视频脚本或其他交付物。最终成果应保存到 03_成果输出,并在后续复盘中提炼其中的新结论、真实案例和有效模板。输入、整理、方法沉淀、成果输出和再次复盘连成闭环,知识库才会越用越贴合个人需求。
**落地原则:**先跑通一个来源、一个每日整理任务和一种成果输出。闭环稳定后再扩展工具,避免把时间花在搭建复杂但无人使用的系统上。