主题
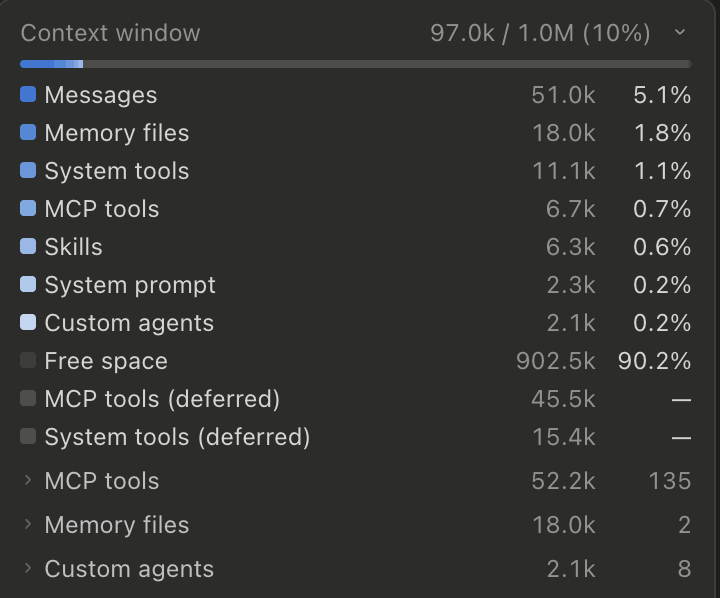
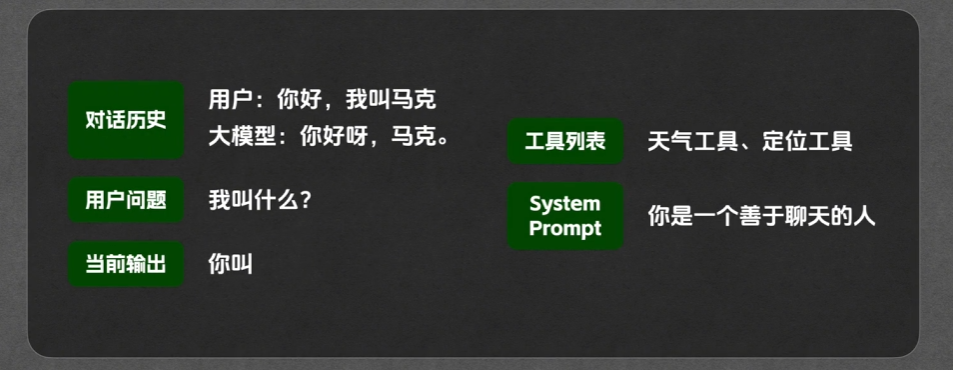
每次对话过程中,并不会只发当次的问题,而是会自动把之前的整段对话历史一起发送出去,所以模型每次看到的都是完整的对话内容。上下文(Context)即是大模型每次处理任务时所接收到的信息总和。
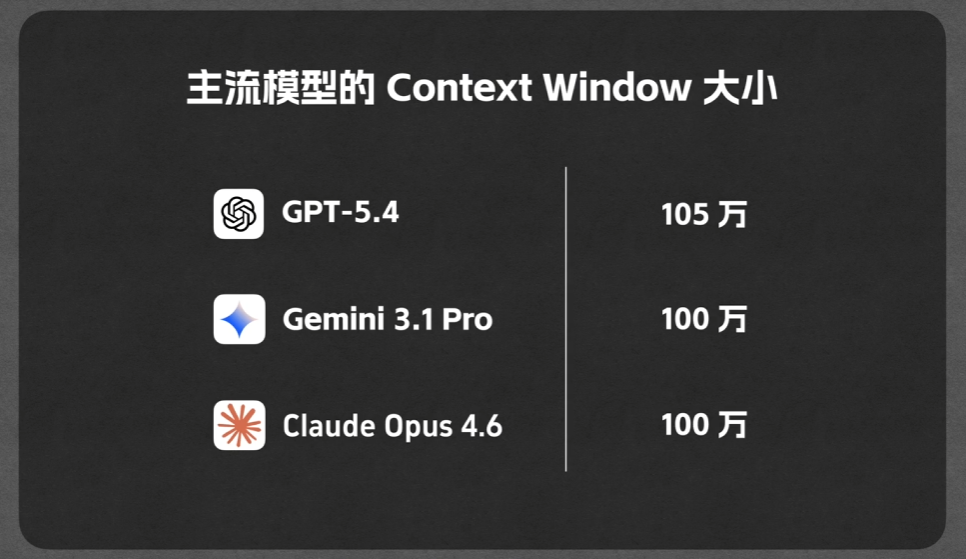
上下文包括用户问题和对话历史、大模型正在输出的 Token、工具列表、System Prompt等信息。上下文窗口(Context Window)指的是上下文能容纳的最大「Token数量」。100万 Token 大约是 150 万个中文汉字,相当于一篇长篇小说的内容。
如果我们有庞大的数据资料,远超上下文窗口的容量限制,需要 AI 从中找到与我们问题相关的内容作为依据进行回答,则需要搭建 RAG 知识库(Retrieval-Augmented Generation,检索增强生成),让模型在回答问题之前,先从海量文档中检索出相关事实,然后再基于这些事实生成答案。这样可以有效缓解大模型时效性不足以及幻觉问题。
上下文的限制是我们要做subagent、skill等机制最重要的原因。
想让 CC 更懂你的习惯、不用每次都重复交代,有三条路,由浅入深:写一份"规则说明书"(CLAUDE.md)、让它自动把偏好记下来(Auto-memory)、把整套固定流程封装成技能(Skill)。
第一条,CLAUDE.md,相当于 CC 的"规则说明书"——每次开工它都先读一遍,把里面的话当默认约定照做。它分两级:全局级放在 ~/.claude/CLAUDE.md,对你电脑上所有项目都生效,适合写通用习惯,比如"始终用中文回复""汇报先给结论再展开";项目级放在具体项目的根目录,只对当前这个项目生效,适合写项目专属的规矩,比如技术栈、目录结构、代码风格。项目级这份还能跟着代码一起提交到 Git,团队每个人拉下来就共享同一套规则,省掉口头对齐。写法就是大白话,想到一条写一条,写得越具体 CC 越照做。
第二条,Auto-memory(自动记忆)。CLAUDE.md 要你自己动手写,Auto-memory 则是让 CC 在聊天里自动把你透露的偏好存下来——你随口说一句"我喜欢深色主题""以后测试都用 pytest",它就记住,下次自动遵守,不用你反复交代;哪条不想要了,也能让它改掉或忘掉。可以这么理解:CLAUDE.md 是你正式、成体系地立规矩,Auto-memory 是日常边用边攒的零散偏好,两者叠加,CC 就越用越顺手。
第三条,自行构建技能,也就是subagent、Skill。当某一类活儿有一套固定的步骤和讲究——比如"每次写周报都要按固定格式、从这几处取数、最后同步到飞书"——与其每次靠聊天反复交代,不如把整套流程封装成一个 Skill,用时一句话唤起,CC 就照里面写好的规程一步步跑完。一句话区分:CLAUDE.md 管"约定",Skill 管"流程";前者是时时生效的背景规则,后者是需要时才唤起的标准作业。
三者怎么选:一句话的通用习惯写进全局 CLAUDE.md;项目专属规矩写进项目级 CLAUDE.md 并提交 Git 团队共享;懒得动手、想让它自己记的零散偏好交给 Auto-memory;只有那种有固定步骤、要反复跑的成套任务,才值得花力气封装成 Skill。按需要从小往大加就行,不用一上来就上重的。
保护上下文的几个技巧:
大多数情况下,对于一兆的上下文,我们使用1/3左右就差不多了,就可以考虑切换回话、压缩(/compact)或者清除上下文(/clear)。
claude.md中只写最关键的的那东西,删除不必要的mcp、skill,定期清理记忆。